O Amazon EC2 Auto Scaling e o Elastic Load Balancing (ELB) ajudam a adaptar uma aplicação às mudanças de demanda e melhorar sua disponibilidade.
O Auto Scaling ajusta a quantidade de instâncias. O ELB distribui o tráfego entre os destinos configurados. Eles podem ser utilizados separadamente ou em conjunto.
Amazon EC2 Auto Scaling
O Amazon EC2 Auto Scaling permite adicionar ou remover instâncias EC2 conforme as regras e os limites definidos para a aplicação.
Adicionar instâncias é chamado de scale out. Remover instâncias é chamado de scale in. Esse ajuste da quantidade de instâncias é uma forma de escalabilidade horizontal.
O serviço também monitora a integridade das instâncias e pode substituir as que apresentam falhas para manter a capacidade desejada.
Grupos de Auto Scaling
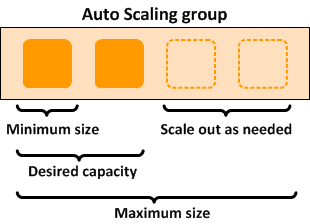
Um grupo de Auto Scaling, também chamado de Auto Scaling group (ASG), reúne instâncias EC2 que são gerenciadas em conjunto.
Você define três valores principais:
- Capacidade mínima: limite inferior configurado para o grupo.
- Capacidade desejada: quantidade de instâncias que o grupo busca manter naquele momento.
- Capacidade máxima: limite superior configurado para o grupo.
Por exemplo, um grupo pode ter mínimo de uma instância, capacidade desejada de duas e máximo de quatro.
Formas de dimensionamento
O número de instâncias pode ser ajustado de diferentes maneiras:
- Manual: você altera a capacidade desejada do grupo.
- Dinâmica: políticas ajustam a capacidade conforme métricas, como a utilização de CPU.
- Agendada: ações ajustam a capacidade em datas e horários definidos.
- Preditiva: utiliza padrões históricos de demanda para antecipar aumentos de capacidade.
Por exemplo, uma loja pode usar o dimensionamento dinâmico para responder ao aumento de acessos. Se já conhece os horários de maior movimento, pode utilizar ações agendadas.
Modelos de lançamento
Um modelo de lançamento, ou launch template, define configurações utilizadas para criar as instâncias EC2 do grupo, como:
- A imagem de máquina, chamada de AMI.
- O tipo de instância.
- Os grupos de segurança.
- As configurações de armazenamento.
Os modelos ajudam a criar instâncias com configurações consistentes e permitem manter diferentes versões dessas configurações.
A AWS recomenda utilizar modelos de lançamento para acessar os recursos mais recentes do EC2 Auto Scaling.
Elastic Load Balancing (ELB)
O Elastic Load Balancing distribui automaticamente o tráfego recebido entre destinos, como instâncias EC2, contêineres e endereços IP, conforme o tipo de balanceador.
Ele funciona como um ponto de entrada para a aplicação. Em vez de o usuário acessar diretamente uma instância, o balanceador encaminha a solicitação para um destino.
O ELB ajusta a capacidade do próprio balanceador conforme as mudanças no tráfego.
Verificações de integridade
As verificações de integridade, ou health checks, ajudam a identificar quais destinos estão disponíveis para receber solicitações.
Essas informações permitem ao balanceador direcionar o tráfego para destinos saudáveis e ajudam a melhorar a disponibilidade da aplicação.
Tipos de balanceadores
Os três tipos de geração atual são:
Application Load Balancer (ALB)
O ALB opera na camada de aplicação, camada 7, e é utilizado para tráfego HTTP e HTTPS.
Ele pode escolher o destino com base em informações da solicitação, como o nome do site ou o caminho da URL.
Por exemplo, pode encaminhar solicitações para /pedidos e /produtos a componentes diferentes de uma aplicação.
Network Load Balancer (NLB)
O NLB opera na camada de transporte, camada 4. Ele oferece suporte a protocolos como TCP, UDP e TLS.
É adequado para aplicações que precisam lidar com grandes volumes de conexões e baixa latência. Também oferece endereços IP estáticos por Zona de Disponibilidade habilitada.
Gateway Load Balancer (GWLB)
O GWLB opera na camada de rede, camada 3, e distribui tráfego para dispositivos virtuais de rede.
Por exemplo, pode encaminhar tráfego para firewalls e sistemas de inspeção de segurança.
| Tipo | Principal utilização | Exemplo |
|---|---|---|
| ALB | Aplicações HTTP e HTTPS, com roteamento baseado nas solicitações. | Encaminhar caminhos de um site para diferentes componentes. |
| NLB | Tráfego de transporte, como TCP e UDP, com baixa latência. | Distribuir muitas conexões TCP. |
| GWLB | Distribuição de tráfego para dispositivos virtuais de rede. | Encaminhar tráfego para firewalls. |
Usando Auto Scaling e ELB juntos
Quando você integra um grupo de Auto Scaling a um balanceador, as novas instâncias são registradas automaticamente. As instâncias encerradas são removidas do balanceamento.
Por exemplo, em uma aplicação web:
- O ALB recebe as solicitações e as distribui entre as instâncias.
- Uma política do EC2 Auto Scaling detecta a necessidade de aumentar a capacidade.
- O grupo adiciona instâncias, respeitando os limites configurados.
- As novas instâncias passam a receber tráfego após o registro e as verificações necessárias.
Distribuir as instâncias por mais de uma Zona de Disponibilidade também ajuda a reduzir o impacto de uma falha em uma única zona.
Diferença entre Auto Scaling e ELB
| Recurso | Principal função |
|---|---|
| Amazon EC2 Auto Scaling | Ajustar a quantidade de instâncias EC2 e substituir instâncias com falhas. |
| Elastic Load Balancing | Distribuir o tráfego entre os destinos registrados. |
Lembre-se: Auto Scaling ajusta a capacidade da aplicação. ELB distribui o tráfego.